문제 해결
추천 로직 병목 분석 (사후 개선)
- 문제
- 추천 결과는 상위 몇 건만 필요한데 전체 데이터를 읽고 문자열 탐색과 정렬을 반복했습니다.
- 해결
- 키워드는 DB의 비트마스크 필터와 BIT_COUNT로 계산하고, MBTI 추천은 성별·연령 후보군에서 PriorityQueue로 상위 12건만 유지했습니다.
- 결과
- 조회 대상과 정렬 범위를 줄여 두 추천 경로의 평균 응답 시간을 단축했습니다. 아래는 로컬 테스트 결과입니다.
PROJECT 05
MBTI 기반 여행지 추천 커뮤니티
Glople은 여행자의 MBTI와 여행 취향에 맞는 여행지를 추천하고, 현지 전문가 '글로플러'와 연결해 주는 여행 커뮤니티 플랫폼입니다. 세계 지도에서 나라를 골라 정보와 리뷰를 보고, 취향 키워드나 MBTI로 여행지를 추천받으며, 성향이 비슷한 다른 여행자의 루트를 참고할 수 있습니다. 글로플러와는 실시간 채팅으로 일정을 상담하고 예약까지 진행합니다.
사용자 성향과 선택 키워드로 여행지·경로를 추천하는 로직을 구현했습니다.
01
지도에서 나라를 고르면 최근 여행 리뷰와 예약 바로가기가 열립니다.
고른 여행 키워드와 MBTI에 맞는 여행지를 추천합니다.
연령·성별·MBTI가 비슷한 여행자의 루트를 코사인 유사도로 찾아 보여 줍니다.
Google Places와 위키백과 정보를 모아 장소 소개와 리뷰를 보여 줍니다.
WebSocket 실시간 채팅에 AI 챗봇 상담과 음성 메시지 텍스트 변환을 더했습니다.
매칭 → 진행 → 입금 → 완료 단계로 예약을 관리하고 포인트를 적립·차감합니다.
02
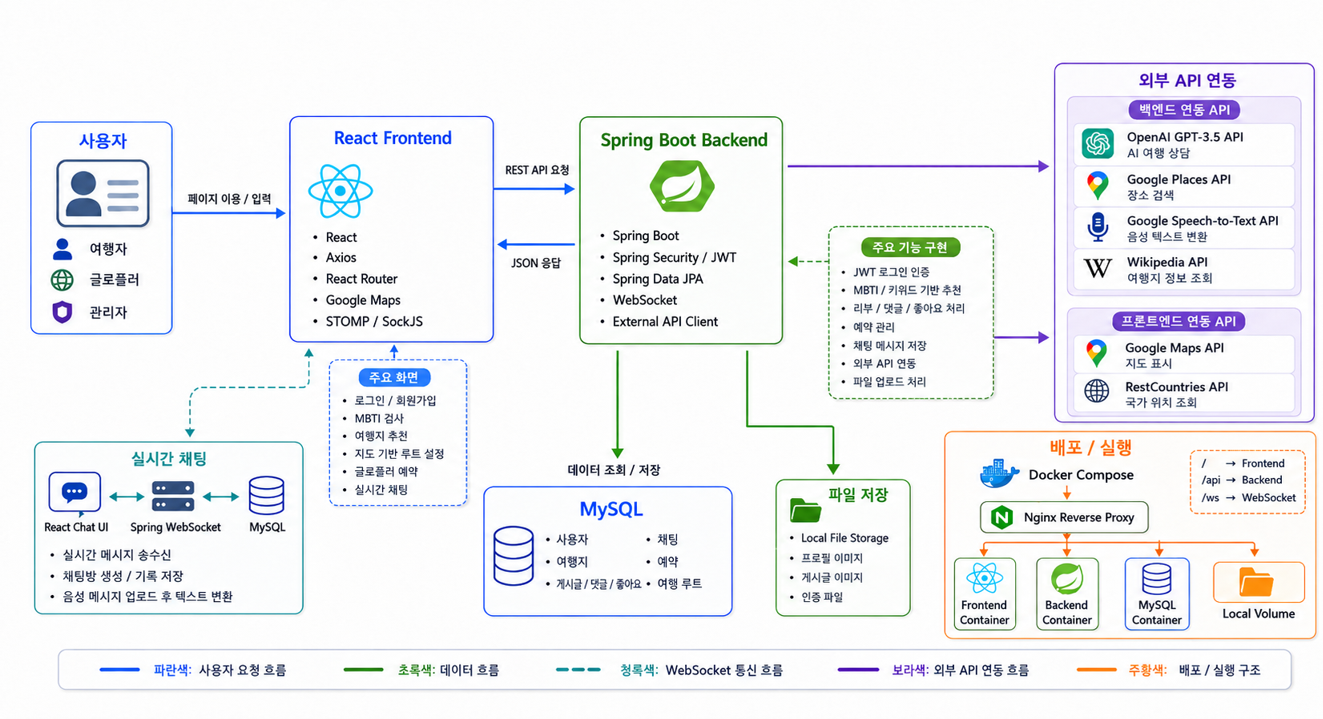
추천 연산은 서버에 두고, 여행 정보 보강은 외부 API 매시업으로 처리해 자체 데이터 부족을 메웠습니다.
여행지 추천 입력 인터페이스, 결과 시각화, 커뮤니티 UI 전반 담당
추천 알고리즘 처리, 외부 API 연동 제어, REST API 및 실시간 통신 중계
사용자 간의 실시간 매칭 상태 공유 및 채팅 메시지 송수신 흐름 처리
사용자 성향(MBTI 등), 여행지 메타데이터, 사용자 루트 및 후기 데이터 관리
OpenAI(자연어 추천), Google Places/Wikipedia(여행 정보 보강) 데이터 수집
03
전체 서비스 안에서 직접 구현하거나 공동으로 맡은 기능입니다.
나이·성별·MBTI 유형을 수치 벡터로 변환하고 코사인 유사도를 계산해 유사 사용자의 여행 루트를 추천
고른 키워드와 겹치는 키워드가 많은 여행지부터 추천. 사후 개선에서 94개 키워드를 두 개의 63-bit mask로 바꿔 MySQL BIT_COUNT로 정렬하도록 했습니다.
전체 조회·정렬로 불필요한 연산이 늘어나는 문제를 확인하고, DB 후보 필터링과 PriorityQueue Top-K 방식으로 개선했습니다.
기여 범위
본인 기여는 추천 로직과 일부 프론트엔드입니다. 실시간 매칭·채팅과 외부 API 연동은 팀 서비스의 전체 구성으로 구분합니다. 수치는 로컬 JMeter 비교 결과이며 운영 환경의 성능을 의미하지 않습니다.
04
문제와 해결, 확인한 결과를 적고 실제 코드와 테스트를 근거로 붙였습니다.
문제 해결
05
같은 조건에서 비교한 로컬 측정입니다. 측정 조건을 결과와 함께 적었습니다.
전체 여행지를 읽고 문자열을 비교하던 문제를 DB 비트마스크 필터와 BIT_COUNT 점수 계산으로 해결했습니다.
프로젝트 종료 후 사후 개선한 내용입니다. 로컬 테스트 환경에서 JMeter로 동일 데이터셋과 동일 요청 시나리오의 Before/After 평균 및 p95를 비교했습니다.
repository.findAll().stream()
    .filter(e -> containsAnyKeyword(e.getInfo(), keywords))
    .sorted((a, b) -> Integer.compare(
        countMatchingKeywords(b.getInfo(), keywords),
        countMatchingKeywords(a.getInfo(), keywords)))
    .limit(21)
    .collect(Collectors.toList());
전체 행을 메모리로 로드 · 정렬 비교마다 매칭 수를 다시 계산
-- 두 개의 63-bit mask로 후보와 공통 키워드 수 계산
WHERE (keyword_mask_low & :maskLow) <> 0
   OR (keyword_mask_high & :maskHigh) <> 0
ORDER BY BIT_COUNT(keyword_mask_low & :maskLow)
       + BIT_COUNT(keyword_mask_high & :maskHigh) DESC
LIMIT :limit
후보군과 점수를 DB에서 계산 · 애플리케이션에는 상위 결과만 반환
상위 12건을 위해 전체 사용자를 정렬하던 문제를 후보군 축소와 PriorityQueue Top-K로 해결했습니다.
프로젝트 종료 후 사후 개선한 내용입니다. 로컬 테스트 환경에서 JMeter로 동일 데이터셋과 동일 요청 시나리오의 Before/After 평균 및 p95를 비교했습니다.
findAllUsers()
    .map(this::cosineSimilarity)
    .sorted(Comparator.reverseOrder())
    .limit(12);
전체 사용자 벡터 변환 · O(n log n) 전체 정렬 후 12건만 사용
var candidates = findByGenderAndBirthYear(gender, birthYear);
var topScores = new PriorityQueue<Score>(12);
// 크기 12를 넘으면 최솟값을 버리며 Top-K만 유지
성별·연령으로 후보군 선축소 · 힙 크기를 12로 고정해 정렬 비용 제거
06
기술 이름보다 해결하려던 작업과 적용 이유를 적었습니다.
전체 데이터를 Java에서 문자열로 반복 탐색하는 대신 후보 필터링과 점수 계산을 DB로 옮겼습니다.
성별·연령으로 후보를 먼저 좁히고 크기 12의 힙을 유지해 전체 결과를 정렬하는 비용을 줄였습니다.
07
자료구조를 바꾸기 전에 어떤 데이터가 실제 결과에 필요한지부터 확인했습니다. 후보군 축소와 정렬 범위 제한을 따로 설명하고 동일한 조건의 측정값을 함께 제시하는 것이 개선을 검증하는 기준이 됐습니다.