← 전체 프로젝트

PROJECT 06

BlueMemories

AI 감정 기록 및 멘탈케어 커뮤니티

프로젝트 개요

BlueMemories는 하루의 일기를 기록하면 AI가 감정을 분석하고, 그날의 감정에 맞는 영상을 추천해 주는 감정 기록·멘탈케어 서비스입니다. 월별 감정 캘린더로 감정의 흐름을 돌아볼 수 있고, 1:1 교환일기를 여러 명이 함께 쓰는 공유 일기장과 공개 일기를 나누는 커뮤니티를 제공합니다. 기존 1.0 버전을 디자이너와 함께 리뉴얼한 프로젝트입니다.

주요 구현

일기·커뮤니티를 개발하고 AI 응답 검증과 실패 시 기본값을 사후 개선했습니다.

진행 기간
2024.07 ~ 2024.09
팀 구성
2인 (개발자 1인 + 디자인 1인)
담당 역할
기획 및 백엔드/프론트엔드 개발 총괄

기술 스택

Backend
Spring BootSpring MVCSpring SecurityJWTWebClient
Frontend
Reactstyled-components
Data
MySQLAWS S3
AI / External
OpenAI APIOllamaYouTube Data APINaver Clova (초기 버전)
시연 화면실제 프론트엔드에 시연용 목 데이터를 넣어 재현했습니다
01 · 일기 작성 · 발행본문을 쓰고 발행하면 감정 분석을 거쳐 캘린더에 오늘의 감정이 표시됨
02 · 감정 분석 · 콘텐츠 추천긍정·중립·부정 점수와 감정에 맞춘 추천 영상을 바꿔 보기
03 · 감정 캘린더 · 일기 목록한 달의 감정을 달력으로 보고 목록으로 전환해 훑어보기
04 · 공유 일기장여러 멤버가 이어 쓴 교환일기를 감정 점수와 함께 확인
05 · 커뮤니티 · 댓글공개 일기 피드에서 글을 열어 감정 분석과 좋아요·댓글 확인

01

서비스 소개

서비스 배경
"사용자가 자신의 감정을 더 쉽고 깊이 있게 돌아볼 수 있을까?"라는 질문에서 시작했습니다. 기존 1.0 버전의 아쉬운 점을 보완하기 위해 디자이너와 1:1로 협업해 UI/UX를 전면 개편하고, 1:1 교환일기를 여러 명이 쓰는 공유 일기장과 커뮤니티로 넓혔습니다.
서비스 목표
일기 작성과 콘텐츠 추천이라는 핵심 경험은 유지하면서, 감정 캘린더로 감정 변화를 돌아보게 하고 공유 일기장과 커뮤니티로 감정을 나누는 경험을 더합니다.
대상 사용자
일상의 감정을 기록하고 돌아보며, 가까운 사람들과 일기를 나누고 싶은 사용자

주요 기능

  • 일기 작성 · 조회

    제목·본문·날씨·공개 여부·이미지를 함께 기록하고, 날짜별 조회와 검색을 지원합니다.

  • AI 감정 분석

    일기의 긍정·중립·부정 점수를 분석합니다. (당시 Naver Clova, 이후 OpenAI·Ollama로 개선)

  • 감정 캘린더

    한 달의 감정을 표정 아이콘 달력으로 보여 줍니다.

  • 콘텐츠 추천

    감정에 맞는 노래와 검색어를 만들고 YouTube 영상을 추천합니다.

  • 공유 일기장

    일기장을 만들고 멤버를 초대·수락해 함께 쓰며, 제목·내용·닉네임으로 검색합니다.

  • 커뮤니티

    공개한 일기를 카드 목록으로 보고 댓글과 좋아요를 남깁니다.

02

시스템 아키텍처

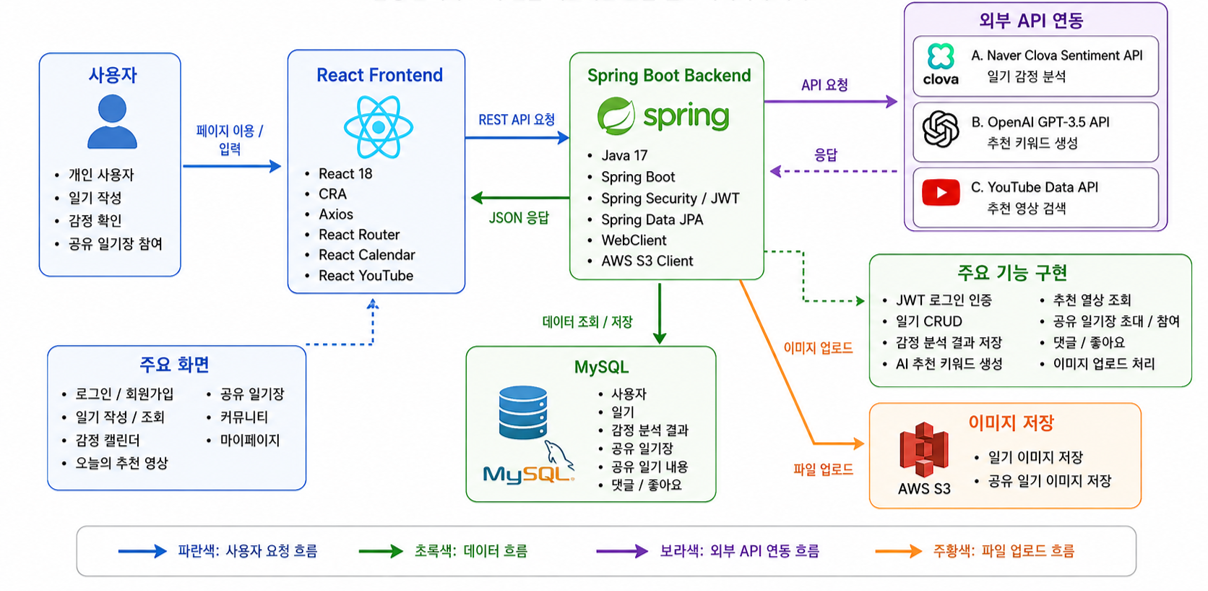
BlueMemories React 프론트엔드, Spring Boot 백엔드, MySQL, 외부 AI·영상 API와 AWS S3 구조를 보여주는 시스템 아키텍처
BlueMemories 시스템 아키텍처이미지를 누르면 크게 볼 수 있습니다

감정 분석과 추천처럼 외부 응답에 의존하는 구간에 JSON 검증·제한된 재시도·기본값 fallback을 적용해 일기 저장 흐름이 중단되지 않도록 구성했습니다.

구성 요소별 역할

  • React

    일기 작성, 감정 캘린더, 커뮤니티 화면 및 사용자 인터랙션 담당

  • Spring Boot

    일기, 공유 일기장, 댓글, 공감, 추천 로직 등 핵심 API 비즈니스 로직 처리

  • MySQL

    사용자 프로필, 일기 데이터, 감정 분석 결과, 커뮤니티 관계망 저장

  • AI APIs

    OpenAI 또는 Ollama로 감정·추천 JSON을 생성하고 YouTube API로 콘텐츠 검색, 초기 버전에서는 Naver Clova 사용

  • AWS S3

    일기 내 첨부 이미지 및 정적 리소스를 서버와 분리하여 효율적으로 관리

03

구현 기능

전체 서비스 안에서 직접 구현하거나 공동으로 맡은 기능입니다.

  • 01

    일기 작성·조회 구현

    일기 작성과 날짜·월별·사용자별 조회, 제목·내용 검색 REST API 및 사용자 인터페이스 구현

  • 02

    AI 감정 분석 연동

    초기 Naver Clova 분석에서 확장해 OpenAI 또는 Ollama를 선택하고 JSON 감정 점수를 검증하도록 구성했습니다.

  • 03

    맞춤형 콘텐츠 추천

    OpenAI와 YouTube API를 조합하여 분석된 감정에 어울리는 음악 및 영상 추천 로직 설계

  • 04

    공유 일기장 확장

    기존 1:1 교환일기 방식에서 N:M 그룹 공유 일기장 구조로 데이터 스키마 및 기능 확장

  • 05

    인증 및 파일 저장

    JWT 기반 보안 인증 체계 구축 및 AWS S3를 연동한 이미지 업로드/관리 구조 최적화

  • 06

    커뮤니티 목록 DTO Projection

    Entity 조회 후 연관 데이터를 반복 조회하던 문제를 작성자 정보와 집계값을 바로 반환하는 DTO Projection으로 해결했습니다.

기여 범위

기획과 개발을 담당하고 디자이너 1인과 협업했습니다. AI 응답 계약·기본값 처리와 목록 조회 개선은 프로젝트 종료 후 진행한 사후 개선입니다.

04

트러블슈팅

문제와 해결, 확인한 결과를 적고 실제 코드와 테스트를 근거로 붙였습니다.

문제 해결

AI 응답 형식 변동에 대응

문제
추천 응답을 정규식으로 파싱해, AI가 문구나 순서를 바꾸면 키워드가 누락됐습니다.
해결
songs[]와 searchKeywords[]를 JSON 계약으로 정의하고 DTO에서 필드와 개수를 검증했습니다. 파싱 실패 시에는 기본 추천값을 사용합니다.
결과
형식 오류를 서버에서 감지하고, AI 응답에 문제가 있어도 추천 화면이 중단되지 않도록 했습니다.
RecommendationResponse.jsonjson
{
  "songs": ["밤편지 아이유", "Through the Night IU"],
  "searchKeywords": ["잔잔한 새벽 플레이리스트", "마음이 편해지는 영상"]
}
판단 과정 단계별로 보기
  1. 정규식 기반 파싱 구조

    프롬프트로 번호 형식을 유도하고 문자열에서 추천 키워드를 추출했습니다. "1. 노래 / 3. 검색어" 같은 번호 형식에 의존해 Pattern 정규식으로 타입과 내용을 분리하는 방식이었습니다.

  2. 응답 형식 변형에 취약

    응답 순서나 문구가 조금만 바뀌어도 키워드 추출에 실패했습니다. GPT가 표현을 섞거나 순서를 바꾸면 누락이 발생했고, 고정 형식에서만 동작하는 한계가 있었습니다.

  3. JSON 계약 + DTO 검증 구조

    songs[], searchKeywords[] 형태의 JSON 응답으로 고정하고, ObjectMapper로 AiRecommendationResponse에 파싱했습니다. songs 2개, searchKeywords 2개를 필수 조건으로 두어 필드 누락·개수 불일치를 서버에서 감지합니다.

  4. fallback 처리

    파싱 실패 시 기본 추천값을 반환해 사용자 흐름을 유지했습니다.

05

성능 개선

같은 조건에서 비교한 로컬 측정입니다. 측정 조건을 결과와 함께 적었습니다.

커뮤니티 목록 — 일기별 반복 조회를 DTO Projection 한 번으로 (사후 개선)

공개 일기를 모두 불러온 뒤 일기마다 작성자를 지연 로딩하던 목록을, 작성자 닉네임과 댓글·좋아요 수를 한 쿼리에서 집계하는 DTO Projection과 페이지 단위 조회로 바꿨습니다.

측정 결과

before → after
Avg Response Time-97.5%
147.85ms
3.63ms

프로젝트 종료 후 사후 개선한 내용입니다. 로컬 환경에서 JMeter로 같은 데이터와 요청 시나리오의 평균 응답 시간을 비교했습니다.

Before: 전체 조회 후 일기마다 작성자 조회

java
List<Diary> diaries = diaryRepository.findByIsPrivate(false);
for (Diary diary : diaries) {
    diaryDtos.add(new DiaryDto(diary.getId(), diary.getTitle(),
            diary.getContent(), diary.getUser().getNickname(),
            diary.getImageUrl()));
}

공개 일기 전체를 한 번에 반환 · 일기 수만큼 작성자 조회 쿼리가 추가로 발생

After: DTO Projection + 페이지 조회

java
select new com.backend.dto.PublicDiaryListResponse(
    d.id, d.title, d.sentiment, d.createdAt, u.nickname,
    count(distinct c.id), count(distinct l.id), d.imageUrl)
from Diary d
join d.user u
left join d.comments c
left join d.userLikes l
where d.isPrivate = false
group by d.id, d.title, d.sentiment, d.createdAt, u.nickname, d.imageUrl

작성자·댓글 수·좋아요 수를 한 쿼리로 집계 · Pageable로 페이지 단위 조회

06

기술 선택 이유

기술 이름보다 해결하려던 작업과 적용 이유를 적었습니다.

JSON 응답 계약 · DTO 검증

추천 응답의 필드와 개수 확인

번호와 문구에 의존하는 정규식 대신 구조화된 응답을 검증하고 파싱 실패 시 기본 추천값을 제공합니다.

MySQL · DTO Projection

공유 관계 확장과 목록에 필요한 데이터 조회

1:1 교환일기를 N:M 공유 일기장으로 확장하고, 작성자 정보와 집계값은 목록 응답에 바로 반환하도록 개선했습니다.

07

회고

외부 AI 응답은 언제든 형식이 달라질 수 있는 입력으로 다뤄야 했습니다. 정상 응답의 계약을 정의하는 것과 실패 시에도 일기 작성 흐름을 유지하는 기본값 설계를 함께 적용했습니다.